
本课程属于理论和实践相结合的案例。通过本课程大家可以学习通过python 如何进行网络爬虫
知识点如下:
HTTP的概念以及request请求头各个参数的学习
同一IP频繁访问的限制以及爬虫伪装及反爬技术及响应报文的参数
讲解requests模块中API方法及通过实战案例具体应用且配合服务器
具体讲解lxml模块以及XPath常用的规则以及在项目中如何进行应用
实战项目来实现原生代码如何网络爬取数据的:获取美食网站中图片
讲解多线程以及队列在爬虫项目中的应用
通过获取所有大学的校名以及学习的简介来巩固多线程爬取数据
下载安装scrapy框架以及通过scrapy.spider类爬取数据
创建scrapy框架以及讲解scrapy框架中item及pipline的作用
通过爬取网络中大学的名称和简介来学习scrapy框架
梳理scrapy架构及各个中间件机制
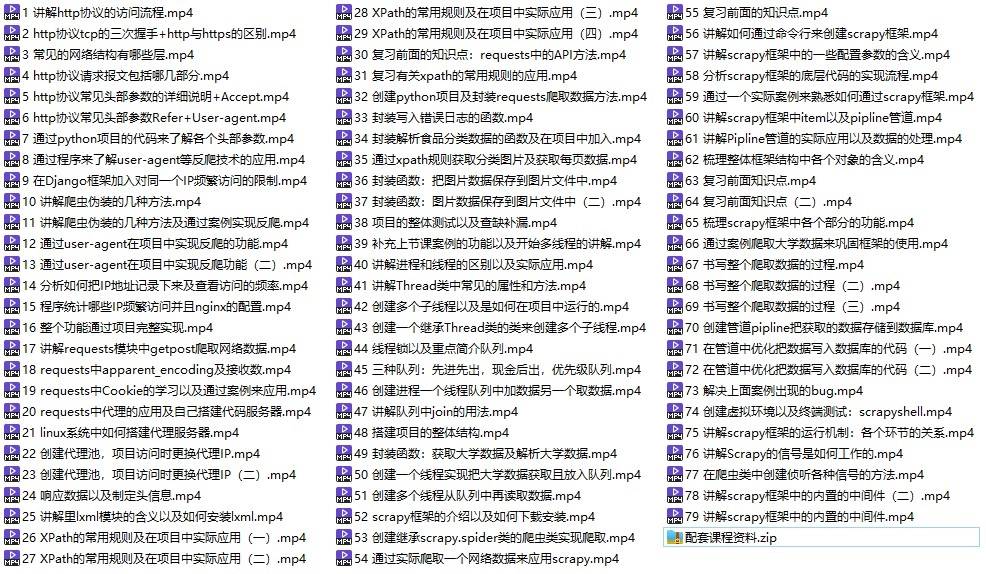
课程目录:
1 讲解http协议的访问流程.mp4
2 http协议tcp的三次握手+http与https的区别.mp4
3 常见的网络结构有哪些层.mp4
4 http协议请求报文包括哪几部分.mp4
5 http协议常见头部参数的详细说明+Accept.mp4
6 http协议常见头部参数Refer+User-agent.mp4
7 通过python项目的代码来了解各个头部参数.mp4
8 通过程序来了解user-agent等反爬技术的应用.mp4
9 在Django框架加入对同一个IP频繁访问的限制.mp4
10 讲解爬虫伪装的几种方法.mp4
11 讲解爬虫伪装的几种方法及通过案例实现反爬.mp4
12 通过user-agent在项目中实现反爬的功能.mp4
13 通过user-agent在项目中实现反爬功能(二).mp4
14 分析如何把IP地址记录下来及查看访问的频率.mp4
15 程序统计哪些IP频繁访问并且nginx的配置.mp4
16 整个功能通过项目完整实现.mp4
17 讲解requests模块中getpost爬取网络数据.mp4
18 requests中apparent_encoding及接收数.mp4
19 requests中Cookie的学习以及通过案例来应用.mp4
20 requests中代理的应用及自己搭建代码服务器.mp4
21 linux系统中如何搭建代理服务器.mp4
22 创建代理池,项目访问时更换代理IP.mp4
23 创建代理池,项目访问时更换代理IP(二).mp4
24 响应数据以及制定头信息.mp4
25 讲解里lxml模块的含义以及如何安装lxml.mp4
26 XPath的常用规则及在项目中实际应用(一).mp4
27 XPath的常用规则及在项目中实际应用(二).mp4
28 XPath的常用规则及在项目中实际应用(三).mp4
29 XPath的常用规则及在项目中实际应用(四).mp4
30 复习前面的知识点:requests中的API方法.mp4
31 复习有关xpath的常用规则的应用.mp4
32 创建python项目及封装requests爬取数据方法.mp4
33 封装写入错误日志的函数.mp4
34 封装解析食品分类数据的函数及在项目中加入.mp4
35 通过xpath规则获取分类图片及获取每页数据.mp4
36 封装函数:把图片数据保存到图片文件中.mp4
37 封装函数:图片数据保存到图片文件中(二).mp4
38 项目的整体测试以及查缺补漏.mp4
39 补充上节课案例的功能以及开始多线程的讲解.mp4
40 讲解进程和线程的区别以及实际应用.mp4
41 讲解Thread类中常见的属性和方法.mp4
42 创建多个子线程以及是如何在项目中运行的.mp4
43 创建一个继承Thread类的类来创建多个子线程.mp4
44 线程锁以及重点简介队列.mp4
45 三种队列:先进先出,现金后出,优先级队列.mp4
46 创建进程一个线程队列中加数据另一个取数据.mp4
47 讲解队列中join的用法.mp4
48 搭建项目的整体结构.mp4
49 封装函数:获取大学数据及解析大学数据.mp4
50 创建一个线程实现把大学数据获取且放入队列.mp4
51 创建多个线程从队列中再读取数据.mp4
52 scrapy框架的介绍以及如何下载安装.mp4
53 创建继承scrapy.spider类的爬虫类实现爬取.mp4
54 通过实际爬取一个网络数据来应用scrapy.mp4
55 复习前面的知识点.mp4
56 讲解如何通过命令行来创建scrapy框架.mp4
57 讲解scrapy框架中的一些配置参数的含义.mp4
58 分析scrapy框架的底层代码的实现流程.mp4
59 通过一个实际案例来熟悉如何通过scrapy框架.mp4
60 讲解scrapy框架中item以及pipline管道.mp4
61 讲解Pipline管道的实际应用以及数据的处理.mp4
62 梳理整体框架结构中各个对象的含义.mp4
63 复习前面知识点.mp4
64 复习前面知识点(二).mp4
65 梳理scrapy框架中各个部分的功能.mp4
66 通过案例爬取大学数据来巩固框架的使用.mp4
67 书写整个爬取数据的过程.mp4
68 书写整个爬取数据的过程(二).mp4
69 书写整个爬取数据的过程(三).mp4
70 创建管道pipline把获取的数据存储到数据库.mp4
71 在管道中优化把数据写入数据库的代码(一).mp4
72 在管道中优化把数据写入数据库的代码(二).mp4
73 解决上面案例出现的bug.mp4
74 创建虚拟环境以及终端测试:scrapyshell.mp4
75 讲解scrapy框架的运行机制:各个环节的关系.mp4
76 讲解Scrapy的信号是如何工作的.mp4
77 在爬虫类中创建侦听各种信号的方法.mp4
78 讲解scrapy框架中的内置的中间件(二).mp4
79 讲解scrapy框架中的内置的中间件.mp4
配套资料.zip
免责声明:本站所有资源版权均属于原作者所有,这里所提供资源均只能用于参考学习用,不得用于商业用途,请遵循相关法律法规。请勿传播使用转载,若由于商用引起版权纠纷,一切责任均由使用者承担。如若本站内容侵犯了原著者的合法权益,联系我们进行处理邮箱∶7512117@qq.com